Cómo diseñar el índice correcto en MongoDB
En este post os voy a intentar explicar cómo diseñar índices en MongoDB a partir de las consultas que ejecuta nuestra aplicación. Veremos cómo detectar una consulta lenta, analizar su plan de ejecución y elegir un índice que nos ayude a mejorar su rendimiento sin crear índices innecesarios.
Un buen índice en MongoDB no nace del esquema de nuestra colección. En una base de datos NoSQL el esquema puede ser flexible e incluso dinámico, así que lo importante es conocer los patrones de consulta reales que ejecuta nuestra aplicación.
Crear índices de forma indiscriminada sobre cada campo de un documento es un error bastante común. Aunque puede hacer que algunas lecturas sean más rápidas, también degrada las escrituras y consume memoria que podríamos necesitar para los datos que se consultan con más frecuencia.
En este post vamos a ver cómo pasar de una consulta lenta a una consulta mucho más rápida utilizando explain("executionStats"), la regla ESR (Equality, Sort, Range), los índices compuestos y el tratamiento especial que requieren los subdocumentos y los arrays.
¿Qué es un índice en MongoDB?
Cuando ejecutamos una consulta sin un índice adecuado, el motor puede tener que realizar un COLLSCAN (Collection Scan). Esto significa que MongoDB examina los documentos de la colección para comprobar cuáles cumplen las condiciones del filtro.
Un índice es una estructura ordenada independiente de la colección principal. Guarda los valores de los campos indexados junto con una referencia al documento, de forma que el motor puede localizar los candidatos sin recorrer toda la colección. En ese caso veremos un IXSCAN (Index Scan) en el plan de ejecución.
No obstante, que una consulta use un índice no significa automáticamente que esté bien optimizada. Tenemos que comprobar cuántas claves y documentos examina, cuánto tarda y si todavía necesita operaciones costosas, como ordenar todos los resultados en memoria.
Configurando nuestra base de datos de pruebas
Antes de empezar, para poder seguir este post y poder ejecutar todas las pruebas, primero vamos a crear las colecciones y los documentos de ejemplo en MongoDB. Para ello, copiaremos este script completo en la consola de MongoDB Compass.
Abre la shell de MongoDB Compass, pega todo el bloque de código y pulsa Enter. El script se ejecuta contra la conexión activa. Como vamos a insertar 1.000.000 de documentos en cada colección, la operación puede tardar bastante y necesitará espacio de almacenamiento suficiente.
const database = db.getSiblingDB("mongoDbIndexes");

database.tickets.drop();
database.orders.drop();

database.createCollection("tickets");
database.createCollection("orders");

const totalDocuments = 1_000_000;
const batchSize = 1_000;

function insertInBatches(collection, total, createDocument) {
  let batch = [];

  for (let i = 0; i < total; i += 1) {
    batch.push(createDocument(i));

    if (batch.length === batchSize) {
      collection.insertMany(batch);
      batch = [];
    }
  }

  if (batch.length > 0) {
    collection.insertMany(batch);
  }
}

const userWeightMap = [];
let totalUserWeights = 0;
for (let u = 2; u <= 100; u++) {
  userWeightMap.push({
    userId: `USR-${String(u).padStart(5, "0")}`,
    weight: u
  });
  totalUserWeights += u;
}

function getRandomUserId() {
  let rnd = Math.random() * totalUserWeights;
  for (let i = 0; i < userWeightMap.length; i++) {
    rnd -= userWeightMap[i].weight;
    if (rnd <= 0) {
      return userWeightMap[i].userId;
    }
  }
  return userWeightMap[userWeightMap.length - 1].userId;
}

const totalCompanyWeights = (20 * 21) / 2; // 210
const companyWeightMap = [];
for (let c = 1; c <= 20; c++) {
  companyWeightMap.push({
    companyId: `COMP-${String(c).padStart(3, "0")}`,
    weight: c
  });
}

function getRandomCompanyId() {
  let rnd = Math.random() * totalCompanyWeights;
  for (let i = 0; i < companyWeightMap.length; i++) {
    rnd -= companyWeightMap[i].weight;
    if (rnd <= 0) {
      return companyWeightMap[i].companyId;
    }
  }
  return companyWeightMap[19].companyId;
}

const customerWeightMap = [];
let totalCustomerWeights = 0;
for (let c = 2; c <= 100; c++) {
  customerWeightMap.push({
    customerId: `CUST-${String(c).padStart(5, "0")}`,
    weight: c
  });
  totalCustomerWeights += c;
}

function getRandomCustomerId() {
  let rnd = Math.random() * totalCustomerWeights;
  for (let i = 0; i < customerWeightMap.length; i++) {
    rnd -= customerWeightMap[i].weight;
    if (rnd <= 0) {
      return customerWeightMap[i].customerId;
    }
  }
  return customerWeightMap[customerWeightMap.length - 1].customerId;
}

const availableTags = ["billing", "support", "tech", "escalated", "general"];

function getRandomTags() {
  const count = Math.floor(Math.random() * 3) + 1;
  const shuffled = [...availableTags].sort(() => 0.5 - Math.random());
  return shuffled.slice(0, count);
}

insertInBatches(database.tickets, totalDocuments, (i) => {
  const isReferenceUser = i < 150;
  const userId = isReferenceUser ? "USR-00001" : getRandomUserId();

  return {
    ticketId: `TICKET-${String(i + 1).padStart(7, "0")}`,
    userId: userId,
    status: isReferenceUser
      ? (i < 42 ? "OPEN" : "CLOSED")
      : (i % 3 === 0 ? "OPEN" : "CLOSED"),
    priority: (i % 5) + 1,
    createdAt: new Date(Date.UTC(2025, 0, 1 + (i % 365))),
    subject: `Ticket de consulta número ${i + 1}`,
    clientInfo: {
      companyId: getRandomCompanyId(),
      tier: i % 2 === 0 ? "GOLD" : "SILVER"
    },
    tags: getRandomTags(),
    timeline: [
      { action: "CREATED", by: userId },
      { action: "UPDATED", by: getRandomUserId() }
    ]
  };
});

insertInBatches(database.orders, totalDocuments, (i) => {
  const isReferenceCustomer = i < 150;
  const customerId = isReferenceCustomer ? "CUST-00001" : getRandomCustomerId();

  return {
    orderId: `ORDER-${String(i + 1).padStart(7, "0")}`,
    customerId: customerId,
    status: i % 5 === 0 ? "PENDING" : i % 11 === 0 ? "CANCELLED" : "PAID",
    orderDate: new Date(Date.UTC(2025, 0, 1 + (i % 365))),
    total: Number((((i % 500) + 1) * 9.99).toFixed(2)),
  };
});
El script crea la base de datos mongoDbIndexes, las colecciones tickets y orders y carga 1.000.000 de documentos en cada una. Para simular un entorno de producción real, los identificadores de usuario (userId), cliente (customerId), empresa (companyId) y las etiquetas (tags) siguen una distribución variante ponderada. Sin embargo, los primeros 150 tickets pertenecen fijamente a USR-00001 (de los cuales 42 están abiertos) y los primeros 150 pedidos a CUST-00001, de forma que las consultas del artículo tengan siempre un conjunto de resultados predecible y fácil de localizar. Las colecciones se generan sin índices adicionales para poder comprobar primero el plan de ejecución con COLLSCAN y añadir progresivamente los índices sugeridos en el post.
La carga puede tardar bastante. Hay que tener en cuenta que elimina y vuelve a crear tickets y orders, así que no lo ejecutes contra una base de datos que contenga datos que quieras conservar.
NOTA: El número de documentos examinados y el tiempo exacto dependerán de nuestro equipo, por lo que los valores mostrados en el post son orientativos.
De un COLLSCAN lento a un IXSCAN rápido
Imaginemos una colección tickets con 1.000.000 de documentos. Queremos obtener los tickets abiertos de un usuario.
db.tickets.find({
  userId: "USR-00001",
  status: "OPEN"
})
Antes de crear ningún índice, podemos analizar la consulta con explain.
db.tickets.find({
  userId: "USR-00001",
  status: "OPEN"
}).explain("executionStats")
El resultado tendremos una sección executionStats que contendrá algo parecido a lo que se muestra a continuación.
{
  "executionStats": {
    "executionSuccess": true,
    "nReturned": 42,
    "executionTimeMillis": 317,
    "totalKeysExamined": 0,
    "totalDocsExamined": 1000000,
    "executionStages": {
      "isCached": false,
      "stage": 'COLLSCAN',
    }
  }
}
Para devolver únicamente 42 documentos, MongoDB ha tenido que examinar el millón de documentos de la colección, tardando un total de 317 milisegundos.
En este punto, podemos empezar creando un índice sobre userId.
db.tickets.createIndex({ userId: 1 })Si repetimos la prueba, el plan podría mostrar unos datos análogos a los siguientes (dentro de la sección executionStats), entre otros campos.
{
  "executionStats": {
    "executionSuccess": true,
    "nReturned": 42,
    "executionTimeMillis": 8,
    "totalKeysExamined": 150,
    "totalDocsExamined": 150,
    "executionStages": {
      "isCached": false,
      "stage": 'FETCH'
    }
  }
}
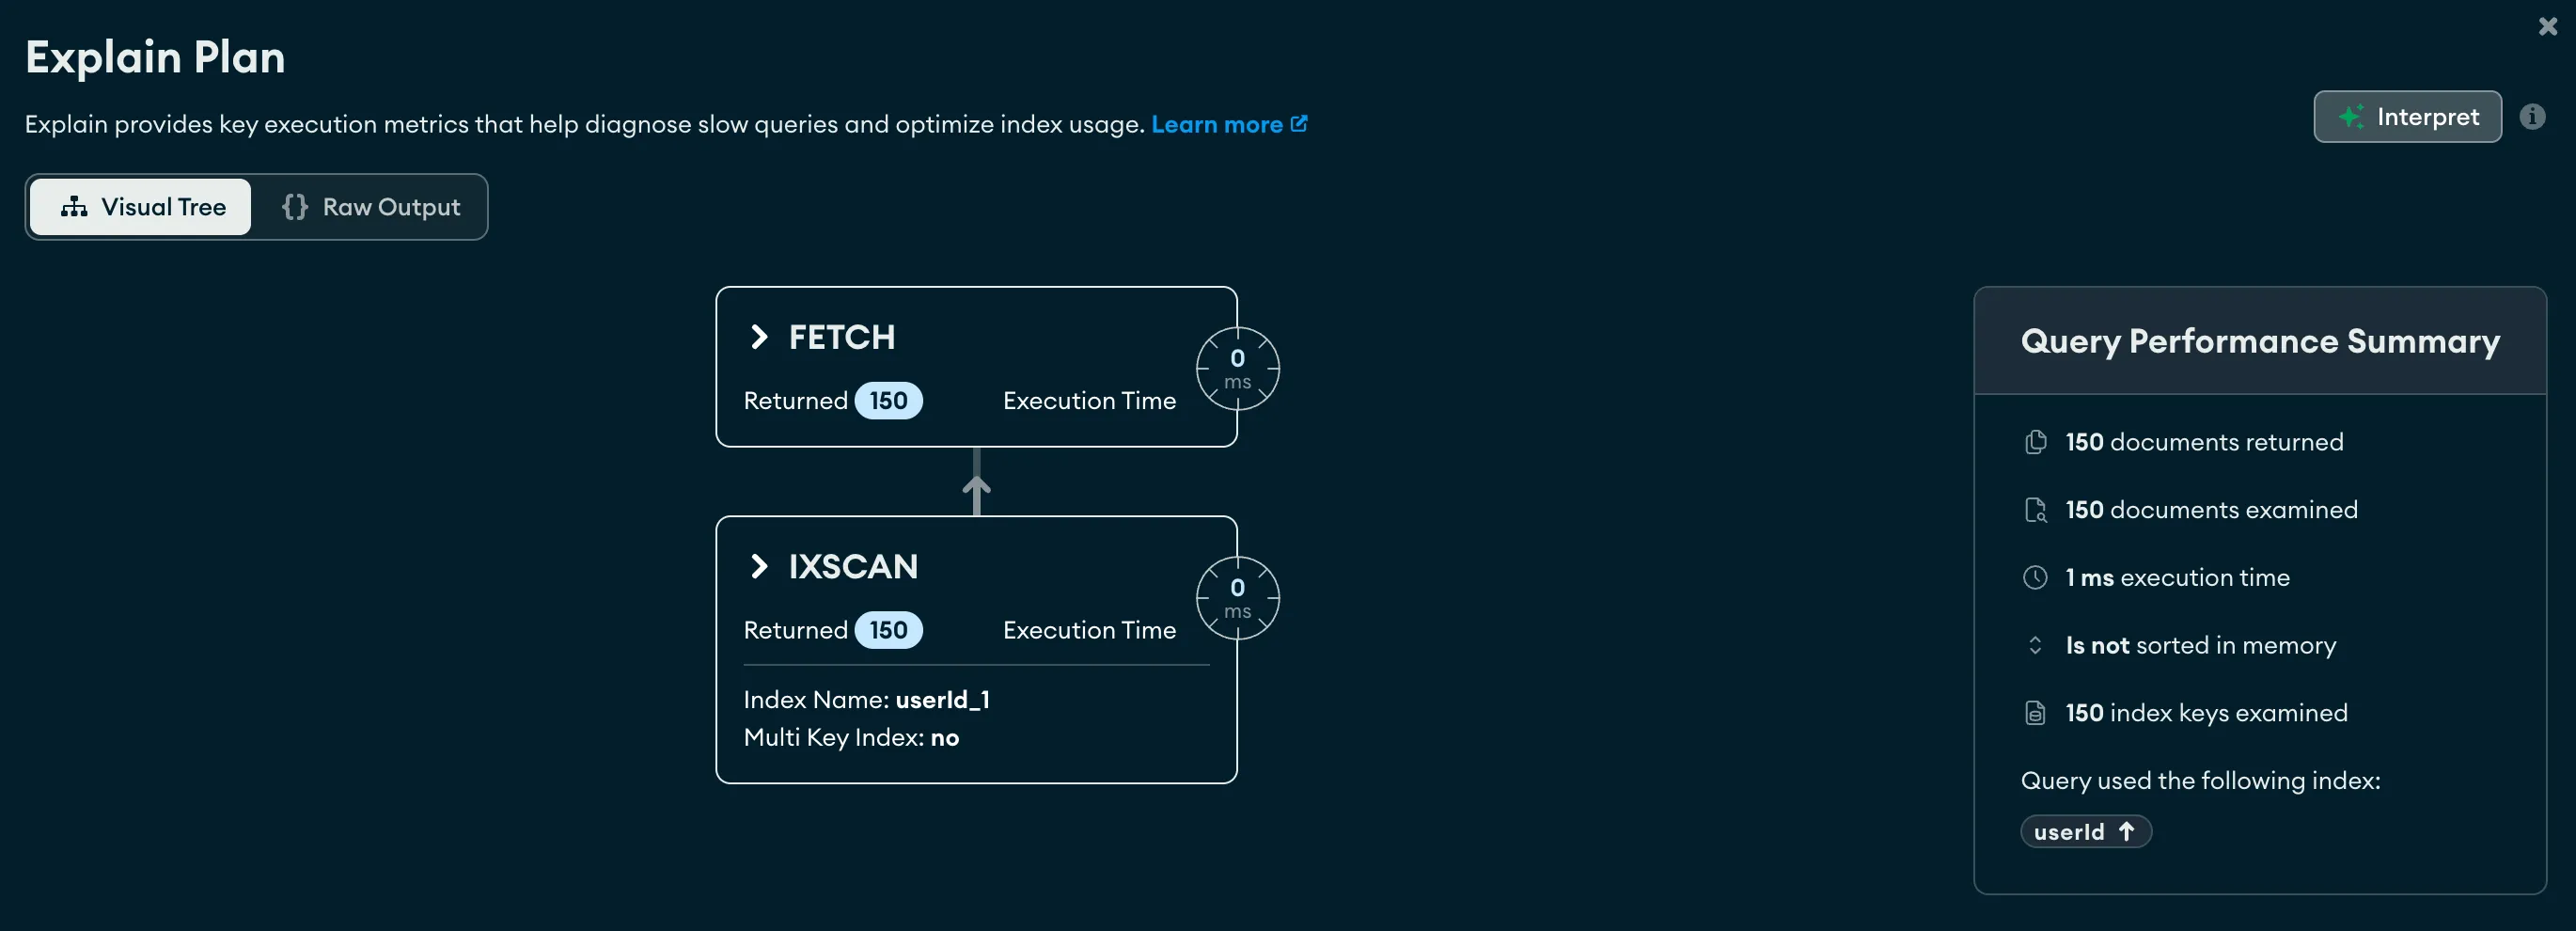
Hemos pasado de leer el millón de documentos a leer únicamente los que corresponden al usuario. En un caso real, los tiempos y las cantidades dependerán de los datos, de la caché y de la configuración del servidor, pero la diferencia entre un COLLSCAN y un IXSCAN puede ser enorme.
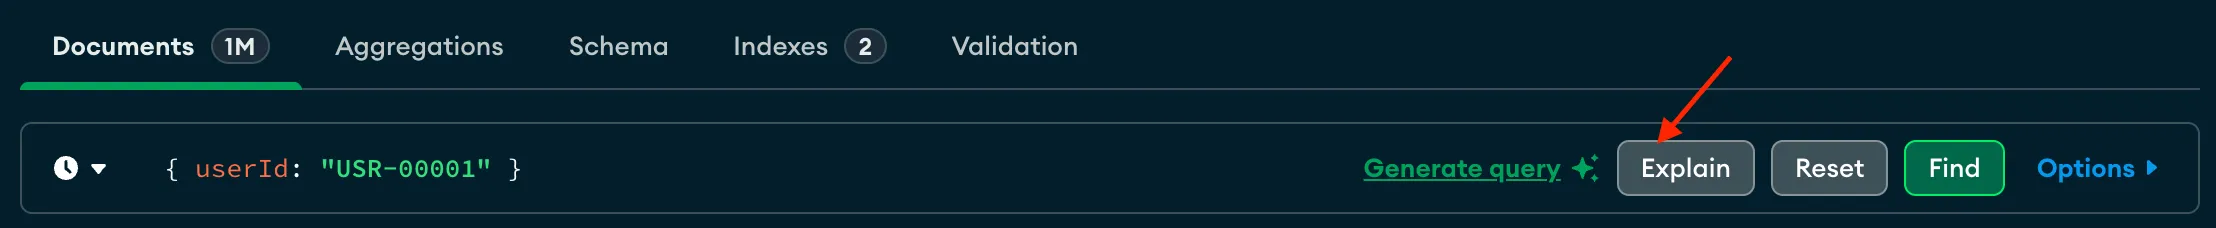
Todo esto también se puede hacer desde MongoDB Compass. Basta con abrir la colección, escribir el filtro en la pestaña Documents y utilizar la opción Explain Plan para consultar las estadísticas de ejecución.
La regla ESR para los índices compuestos
Cuando una consulta combina filtros exactos, ordenación y rangos, una buena regla inicial para diseñar un índice compuesto es ESR.
- Equality (E) - Igualdad: campos filtrados por coincidencia exacta, como
{ status: "OPEN" }. Normalmente deben aparecer al principio del índice. - Sort (S) - Ordenación: campos utilizados en
.sort(), como{ createdAt: -1 }. Colocarlos en el índice puede evitar una ordenación adicional. - Range (R) - Rango: campos que utilizan operadores como
$gt,$gte,$lto$lte, por ejemplo{ priority: { $gte: 3 } }.
Por ejemplo, para esta consulta.
db.tickets.find({
  status: "OPEN",
  priority: { $gte: 3 }
}).sort({
  createdAt: -1
})
Un índice apropiado sería el siguiente.
db.tickets.createIndex({
  status: 1,
  createdAt: -1,
  priority: 1
})
El campo status reduce el conjunto inicial mediante una igualdad. Después, createdAt permite devolver los resultados ordenados y, finalmente, priority acota la búsqueda mediante un rango.
Esta regla es un buen punto de partida, pero no sustituye a explain. Si el rango es muy selectivo, puede ser más eficiente ponerlo antes que el campo de ordenación, siguiendo una estrategia ERS. La elección final debe basarse en las consultas y en los datos reales.
Índices compuestos y la regla de los prefijos
Un índice compuesto sobre { A: 1, B: 1, C: 1 } puede servir para consultas que utilicen los prefijos de la izquierda.
db.collection.find({ A: "valor" }) // Prefijo de un campo
db.collection.find({ A: "valor", B: "valor" }) // Prefijo de dos campos
db.collection.find({ A: "valor", B: "valor", C: "valor" }) // Índice completo
Imaginemos que creamos este índice.
db.orders.createIndex({
  customerId: 1,
  status: 1,
  orderDate: -1
})
Una consulta por customerId y status puede aprovechar el índice.
db.orders.find({
  customerId: "CUST-00001",
  status: "PAID"
}).explain("executionStats")
{
"executionStats": {
"executionSuccess": true,
"nReturned": 109,
"executionTimeMillis": 1,
"totalKeysExamined": 109,
"totalDocsExamined": 109,
"executionStages": {
"isCached": false,
"stage": 'FETCH'
}
}
}Vemos que para devolver 109 documentos no se ha examinado el millón de registros, sino que se ha aprovechado el indice para obtener los resultados examinando justo eso 109 registros.
También puede aprovecharlo una consulta que filtre únicamente por el primer campo.
db.orders.find({
  customerId: "CUST-00001"
}).explain("executionStats")
{
"executionStats": {
"executionSuccess": true,
"nReturned": 150,
"executionTimeMillis": 1,
"totalKeysExamined": 150,
"totalDocsExamined": 150,
...
}
}De forma análoga al punto anterior, vemos que la que se exploran solo los 150 registros que son retornados por la query, sin necesidad de crear un índice independiente sobre { customerId: 1 }.
Sin embargo, una consulta que filtre únicamente por status no utiliza de forma eficiente ese prefijo.
db.orders.find({
  status: "PAID"
}).explain("executionStats")
{
"executionStats": {
"executionSuccess": true,
"nReturned": 727272,
"executionTimeMillis": 255,
"totalKeysExamined": 0,
"totalDocsExamined": 1000000,
...
}
}Tiene que analizar todos los documentos para encontrar el resultado, sin aplicar el indice citado anteriormente, ya que status está ordenado dentro de cada valor de customerId, no como primer campo del árbol. Si esta consulta es frecuente y no existe otro índice que la cubra, habría que crear uno independiente.
db.orders.createIndex({
  status: 1
})
Después de crear este índice, podemos ejecutar de nuevo la consulta por status.
db.orders.find({
  status: "PAID"
}).explain("executionStats")
{
"executionStats": {
"executionSuccess": true,
"nReturned": 727272,
"executionTimeMillis": 292,
"totalKeysExamined": 727272,
"totalDocsExamined": 727272,
"executionStages": {
...
"inputStage": {
"stage": "IXSCAN",
"indexName": "status_1",
...
}
}
}
}Ahora no ha sido necesario explorar el millon de usuarios, ya que existía el nuevo indice que acabamos de crear. Asimismo, si exploramos el JSON retornado con explain, vemos que, efectivamente, se ha usado dicho indice
Con todo lo anterior, podemos concluir que la primera consulta debería poder utilizar el prefijo customerId + status, y la segunda debería utilizar únicamente el prefijo customerId. En cambio, la tercera consulta puede necesitar recorrer más entradas del índice compuesto o incluso realizar un COLLSCAN, porque no filtra por el primer campo. Después de crear { status: 1 }, al repetirla deberíamos ver que utiliza el índice status_1.
En cada resultado debemos comparar winningPlan, totalKeysExamined, totalDocsExamined y executionTimeMillis. Así podemos observar cómo cambia el plan en función de los campos que forman parte de la consulta, en lugar de asumir que cualquier índice compuesto sirve para todas las búsquedas.
Indexando campos anidados (Subdocumentos)
En MongoDB es habitual modelar datos embebiendo documentos dentro de otros. Si tenemos un objeto dentro de nuestro documento, no es necesario indexar el objeto completo (de hecho, suele ser contraproducente porque el orden exacto de las claves dentro del subdocumento afectaría a las coincidencias). Lo recomendable es indexar la ruta exacta mediante la notación de puntos.
Nuestros tickets de prueba incluyen información del cliente embebida (propiedad clientInfo). Si queremos optimizar búsquedas frecuentes por la empresa del cliente, creamos el índice apuntando a la propiedad interna de ese sub-documento.
db.tickets.createIndex({ "clientInfo.companyId": 1 })Ahora podemos ejecutar la siguiente consula para ver como MongoDB utilizará un IXSCAN sobre la propiedad específica sin tener que cargar ni comparar el resto de los campos de clientInfo. Además, estos campos anidados se pueden combinar en índices compuestos siguiendo la regla ESR (por ejemplo, { "clientInfo.companyId": 1, "status": 1 }).
db.tickets.find({ "clientInfo.companyId": "COMP-020" }).explain("executionStats"){
"executionStats": {
"executionSuccess": true,
"nReturned": 95052,
"executionTimeMillis": 75,
"totalKeysExamined": 95052,
"totalDocsExamined": 95052,
"executionStages": {
...
"inputStage": {
"stage": "IXSCAN",
"indexName": "clientInfo.companyId_1",
...
}
}
}
}Índices sobre campos dentro de un Array: Multikey Indexes
¿Qué ocurre si el campo por el que queremos filtrar está dentro de un array de elementos? Aquí entran en juego los Índices Multiclave (Multikey Indexes).
En el script de pruebas, cada ticket contiene un array de etiquetas simples (tags) y un historial de eventos anidados (timeline).
{
  "tags": [
    "support",
    "billing",
    "general"
  ],
  "timeline": [
    {
      "action": "CREATED",
      "by": "USR-00001"
    },
    {
      "action": "UPDATED",
      "by": "USR-00053"
    }
  ]
}
¿Cómo funciona un índice sobre un Array?
Cuando indexamos un array (o un campo interno dentro de los objetos de un array), MongoDB crea una entrada en el índice por cada elemento del array. Si un documento tiene 5 etiquetas, ese único documento generará 5 entradas distintas en la estructura en árbol del índice.
Podemos indexar un array de valores simples.
db.tickets.createIndex({ tags: 1 })O un campo específico dentro de los objetos del array.
db.tickets.createIndex({ "timeline.by": 1 })Rendimiento y restricciones de los Índices Multiclave
Aunque son totalmente recomendables si la aplicación busca con frecuencia dentro de colecciones embebidas, debemos tener en cuenta los siguientes factores.
- Multiplicación del tamaño del índice: Si una colección tiene 1.000.000 de documentos y cada documento tiene un array con 10 elementos, el índice multiclave guardará 10.000.000 de entradas. Esto consume más RAM y penaliza las escrituras y actualizaciones.
- Limitación en índices compuestos (La regla del array único): No se puede crear un índice compuesto en el que más de un campo sea un array. Por ejemplo, un índice sobre
{ tags: 1, "timeline.by": 1 }fallará con un error en MongoDB si ambos campos contienen arrays en el mismo documento, ya que la combinación cartesiana de claves provocaría un crecimiento insostenible.
Comprobando los índices desde MongoDB Compass
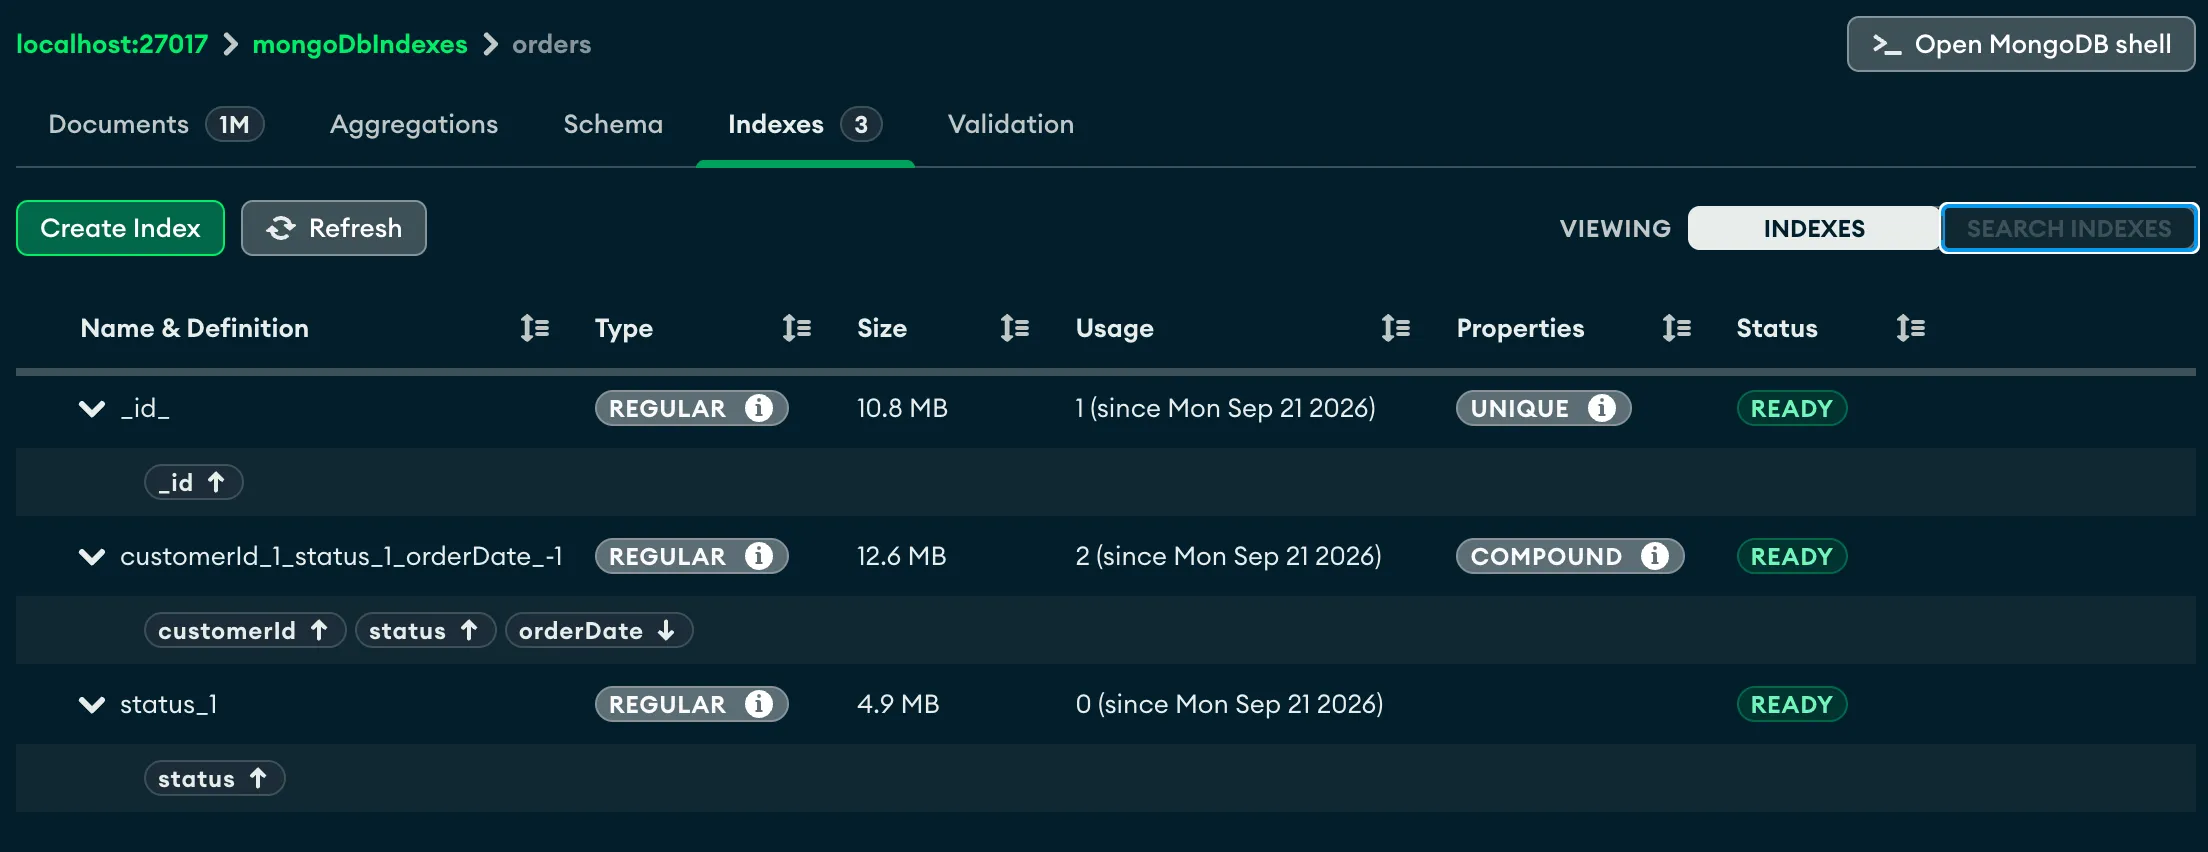
MongoDB Compass también permite crear y revisar índices sin utilizar la consola. Desde la pestaña Indexes podemos ver los índices existentes, crear uno nuevo y comprobar su tamaño.
Para analizar una consulta, podemos utilizar el botón Explain de la pestaña Documents. Después de crear el índice, repetimos la consulta y comprobamos si el plan ha cambiado de COLLSCAN a IXSCAN, si se han reducido los documentos examinados y si se ha eliminado una ordenación en memoria.
El coste oculto de los índices
Cada índice supone un compromiso entre lecturas y escrituras.
- Penalización en las escrituras: en cada inserción, actualización y borrado, MongoDB debe mantener actualizados todos los índices afectados.
- Consumo de memoria: los índices compiten por espacio en la caché con los datos de la colección.
- Coste de mantenimiento: cuantos más índices tengamos, más difícil será saber cuáles siguen siendo necesarios.
Para consultar el uso de los índices de una colección podemos ejecutar una consulta análoga a esta.
db.orders.aggregate([
  { $indexStats: {} }
])
Retornará un análisis de la frecuencia de uso de los índices en la colección especificada (orders para el ejemplo) desde que el servidor se inició o desde que el índice se creó.
Hay dos campos por indice a los que hay que prestar atención.
- ops: Número de veces que una consulta ha utilizado ese índice.
- since: Fecha y hora a partir de la cual el motor de MongoDB comenzó a contabilizar las lecturas sobre ese índice.
Si encontramos índices que no se utilizan y no son necesarios para restricciones de unicidad u otros requisitos, podemos estudiar su eliminación.
Conclusión
Diseñar índices no consiste en indexar todos los campos por si acaso. El proceso recomendable se sintetiza en los siguientes pasos.
- Identificar las consultas que realmente ejecuta la aplicación.
- Medirlas con
explain("executionStats"). - Diseñar un índice que cubra sus igualdades, ordenaciones y rangos (Regla ESR).
- Usar la notación de puntos para subdocumentos y tener presente el coste de los Multikey Indexes en arrays.
- Comprobar los prefijos cuando se trate de un índice compuesto.
- Revisar periódicamente el uso y el coste de los índices con
$indexStats.
Un índice bien elegido puede convertir una consulta que recorre toda una colección en una búsqueda que examina únicamente unas pocas claves y documentos. La clave está en medir antes y después, en lugar de confiar únicamente en las reglas generales.
Fuentes y referencias
- MongoDB Documentation: The ESR (Equality, Sort, Range) Guideline.
- MongoDB Documentation: Compound Indexes.
- MongoDB Documentation: Multikey Indexes.
- MongoDB Documentation: Analyze Query Performance.
- MongoDB Documentation: $indexStats.