MongoDB: ¿cuándo incrustar documentos y cuándo usar referencias?
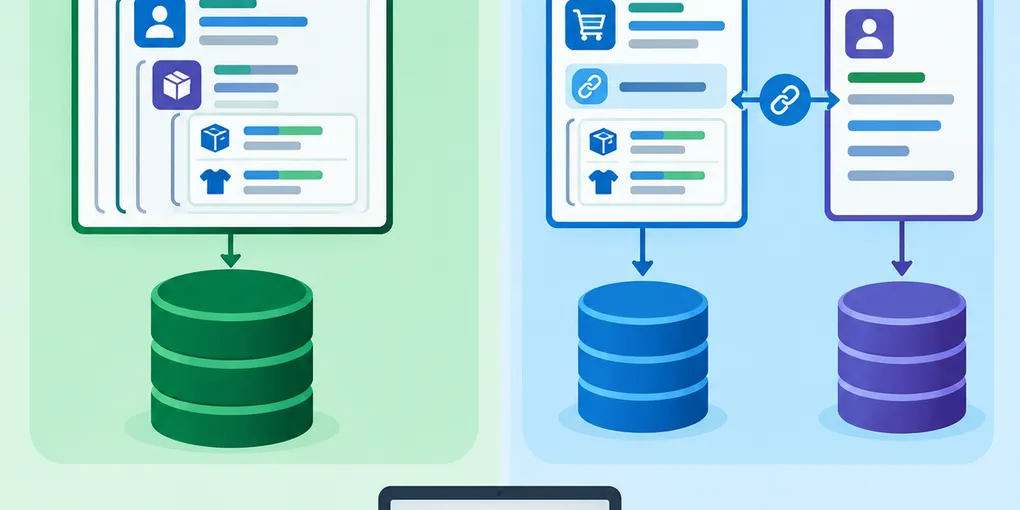
Cuando estamos creando una nueva aplicación, o añadiendo una nueva funcionalidad, una de las primeras decisiones que tenemos que tomar al diseñar una colección en MongoDB es cómo representar las relaciones entre nuestros datos. Por ejemplo, si un pedido tiene varios productos, ¿los guardamos dentro del propio pedido o creamos una colección de líneas de pedido y guardamos referencias a ellas?
En una base de datos relacional, lo normal sería separar las entidades en tablas y relacionarlas con claves externas. En MongoDB podemos hacer algo parecido usando identificadores, pero también podemos guardar un documento dentro de otro.Vamso a ver que ninguna de las dos opciones es siempre correcta o incorrecta, sino que depende de cómo vayamos a leer y modificar los datos que guardemos en esa/s coleccion/es.
En este post quiero comparar ambas alternativas con un ejemplo de pedidos y clientes. Y quiero mostrar las preguntas que creo que nos tenemos que hacer antes de elegir una opción u otra.
Incrustar documentos dentro de otros documentos
Imaginemos un pedido con varias líneas. Cada línea incluye el producto, la cantidad y el precio al que se vendió.
Podemos guardar el pedido completo en un documento, incluyendo todas sus líneas. Un ejemplo podría ser el que se muestra a continuación.
{
  "_id": "ORD-1001",
  "customerId": "CUS-42",
  "createdAt": "2026-10-13T10:15:00Z",
  "status": "Paid",
  "items": [
    {
      "productId": "PRD-10",
      "name": "Teclado",
      "quantity": 1,
      "unitPrice": 79.99
    },
    {
      "productId": "PRD-24",
      "name": "Ratón",
      "quantity": 2,
      "unitPrice": 29.99
    }
  ]
}
En este caso, items es un array de subdocumentos. En C# podríamos representarlo con una clase para el pedido y otra para cada línea.
public sealed class Order
{
    public string Id { get; init; } = string.Empty;
    public string CustomerId { get; init; } = string.Empty;
    public DateTime CreatedAt { get; init; }
    public string Status { get; set; } = string.Empty;
    public List<OrderItem> Items { get; init; } = [];
}

public sealed class OrderItem
{
    public string ProductId { get; init; } = string.Empty;
    public string Name { get; init; } = string.Empty;
    public int Quantity { get; set; }
    public decimal UnitPrice { get; init; }
}
Este diseño funciona especialmente bien cuando las líneas solo tienen sentido dentro de su pedido, cuando lo normal sea recuperr el pedido con todas sus líneas y cuando el número de líneas esté acotado. En este caso, con una sola consulta tendriamos toda la información que necesitamos.
var order = await ordersCollection
    .Find(order => order.Id == orderId)
    .FirstOrDefaultAsync();
A la hora de guardar el pedido, también no saprovechariamos de la ventaja de tener toda la informacion en un único documento, ya que podriamos guardarlo todo en una sola escritura. Las escrituras sobre un documento son atómicas, es decir, MongoDB aplica todos los cambios del documento juntos o no aplica ninguno. Por ejemplo, podríamos cambiar el estado del pedido y actualizar una de sus líneas sin dejar el pedido en un estado intermedio.
Esto no significa que tengamos que incrustar todo lo relacionado con un pedido. Para verlo, podemos poner el ejemplo de los clientes. Estos pueden vivir en su propia colección, porque la información de un cliente se comparte entre muchos pedidos y dichos clientes tiene su propia identidad.
{
  "_id": "CUS-42",
  "name": "Ana",
  "email": "ana@example.com"
}
Por lo tanto, el pedido guardaría un campo customerId como referencia al cliente. Las líneas del pedido sí que quedarían incrustadas en el documento del pedido y se leen junto con él.
Así pues, como acabamos de ver, es perfectamente válido combinar documentos incrustados y referencias en un mismo modelo.
Guardar referencias a documentos de otra colección
Otra opción para las líneas es tenerlas una colección independiente, en vez de tenerlas incrustadas en el pedido. Si lo hacemos así, el pedido guardará los identificadores de sus líneas, por lo que tendríamos el siguiente modelo.
// Pedido
{
  "_id": "ORD-1001",
  "customerId": "CUS-42",
  "createdAt": "2026-10-13T10:15:00Z",
  "status": "Paid",
  "itemIds": ["ITM-1", "ITM-2"]
}

// Linea
{
  "_id": "ITM-1",
  "orderId": "ORD-1001",
  "productId": "PRD-10",
  "name": "Teclado",
  "quantity": 1,
  "unitPrice": 79.99
}
Con este cambios, ahora necesitariamos hacer dos consultas para obtener el pedido y sus líneas.
var order = await ordersCollection
    .Find(order => order.Id == orderId)
    .FirstOrDefaultAsync();

if (order is null)
{
    return;
}

var items = await orderItemsCollection
    .Find(item => item.OrderId == order.Id)
    .ToListAsync();
También podríamos traer ambas colecciones con una agregación que use $lookup, pero eso no elimina el trabajo de pensar cómo se van a consultar los datos ni convierte automáticamente un modelo en el mejor, sino que añade otra alternativa que deberiamos medir con consultas representativas.
Las referencias tienen sentido cuando los documentos relacionados pueden crecer sin límite, se consultan por separado, tienen un ciclo de vida independiente o son compartidos por muchos documentos.
Con todo esto sobre la mesa, vemos que el coste es que, para leer el pedido completo, necesitamos otra consulta o una agregación. Y a la hora de escribir nos pasaría lo mismo, es decir, necesitariamos una escritura sobre el pedido y otra sobre cada una de sus líneas, lo que provoca que la operación ya no sea atómica y nos haga plantearnos si necesitariamos una transacción para guardar toda la información como una única unidad, teniendo en cuenta su coste.
El caso del cliente. Guardar una referencia y una fotografía de los datos
El cliente ilustra por qué no tenemos que elegir una sola estrategia para toda la aplicación. Es razonable mantener el documento del cliente separado y guardar su identificador en el pedido. Pero, si necesitamos conservar los datos tal y como estaban en el momento de la compra, puede ser útil guardar también una copia de algunos campos en el pedido.
{
  "_id": "ORD-1001",
  "customerId": "CUS-42",
  "customerSnapshot": {
    "name": "Ana",
    "email": "ana@example.com"
  },
  "status": "Paid"
}
Si Ana cambia su dirección o su correo más adelante, el pedido sigue conservando la información que tenía cuando se creó. En este caso, no sería una duplicación accidenta, sino es una fotografía histórica que responde a una necesidad del dominio.
Por otro lado, si copiamos en cada pedido todos los datos actuales del cliente sin una razón concreta, cualquier cambio puede obligarnos a actualizar muchos documentos. En ese caso tendríamos que decidir qué pasa si una actualización se queda a medias y cómo mantener las copias sincronizadas.
Preguntas que ayudan a elegir
Antes de modelar una relación, creo que puede resultar útil que nos hagamos las siguientes preguntas.
- ¿Cómo se suelen leer los datos? Si casi siempre necesitamos ambos documentos juntos y el conjunto tiene un tamaño razonable, incrustar puede ser la mejor de las opciones y, así, evitar consultas adicionales.
- ¿Qué tamaño puede alcanzar la relación? Un array de tamaño limitado suele ser manejable. Un array que crece continuamente puede hacer que el documento sea cada vez más pesado y, eventualmente, superar el límite BSON de 16 MiB por documento. En este caso, tendríamos que buscar tener documentos separados para el array.
- ¿Los datos relacionados tienen vida propia? Si se crean, modifican o eliminan independientemente, una colección separada puede reflejar mejor ese ciclo de vida. Este seria el ejemplo del cliente y el pedido. En cuyo caso, cambios en el cliente no tendrían que propagarse a otros documentos, incluso en otras colecciones, por ser una entidad independiente.
- ¿Los mismos datos se comparten entre muchos documentos? Si varios pedidos apuntan al mismo cliente o producto, guardar una referencia evita repetir todos sus datos en cada pedido.
- ¿Qué debe ser atómico? Un documento incrustado permite modificar conjuntamente sus campos. Para mantener varios documentos consistentes como una única operación necesitaríamos una transacción o diseñar el flujo para tolerar estados intermedios.
- ¿Qué información debe permanecer como estaba? Una copia intencionada de los datos en el momento de una operación puede ser mejor que consultar siempre el valor actual.
Como regla general, incrustaría los datos que se consultan juntos, forman parte del mismo ciclo de vida y tienen un crecimiento acotado. Usaría referencias para los datos compartidos, independientes o potencialmente ilimitados. Pero la regla importante es partir de las consultas y operaciones reales, no de intentar reproducir en MongoDB el esquema de una base de datos relacional.
Índices para las consultas habituales
Al elegir entre incrustar y referenciar, también tenemos que pensar en cómo vamos a localizar los documentos. Si vamos a consultar los pedidos de un cliente y mostrarlos del más reciente al más antiguo, podríamos crear un índice compuesto sobre customerId y createdAt.
db.orders.createIndex({ customerId: 1, createdAt: -1 })Si las líneas están en una colección separada y las buscamos por orderId, podemos indexar ese campo.
db.orderItems.createIndex({ orderId: 1 })Como vimos en el post sobre cómo diseñar índices en MongoDB, no basta con que una consulta utilice un índice. Hay que comprobar el plan con explain("executionStats") y tener en cuenta también el coste que los índices añaden a las escrituras.
Conclusión
Incrustar o referenciar no es una decisión global que tengamos que tomar para toda la aplicación. Podemos guardar las líneas dentro del pedido y mantener clientes y productos en colecciones separadas, o incluso copiar parte de sus datos cuando necesitamos conservar una fotografía histórica.
La mejor estructura es la que hace sencillas y eficientes las operaciones que nuestra aplicación ejecuta de verdad, sin crear documentos que crecen sin control ni añadir referencias y consultas adicionales porque sí. Si no tenemos claro cuál de las dos opciones encaja, podemos modelar el caso con datos representativos y medir las consultas antes de complicar el diseño.